近日,我院在生物信息学知名期刊《Briefings in Bioinformatics》(中科院1区,IF=7.7)上发表了最新研究成果。论文标题为“ProTCR: A protein language model-driven framework for decoding TCR-antigen recognition toward precision immunotherapies”。该工作由基因组与生物信息研究所硕士研究生许珉瑞和在职博士生鲁曼曼共同担任第一作者,谢鹭研究员担任通讯作者。
T细胞受体(TCR)对抗原表位的识别,是启动和维持适应性免疫反应的核心环节,也直接影响新抗原疫苗、TCR-T疗法等精准免疫治疗的效果。然而,该领域一直面临两大挑战:实验方法虽可靠,但往往耗时费力、通量有限且样本难得;而现有的计算模型,大多依赖已知的肽段–TCR配对数据,一旦遇到临床中常见的“未知抗原”或MHC II类分子递呈的复杂长肽,预测性能与泛化能力往往不足。要突破这些瓶颈,亟需开发一个能够超越已有数据局限、在分布变化与数据稀缺条件下依然稳健可靠的人工智能模型。
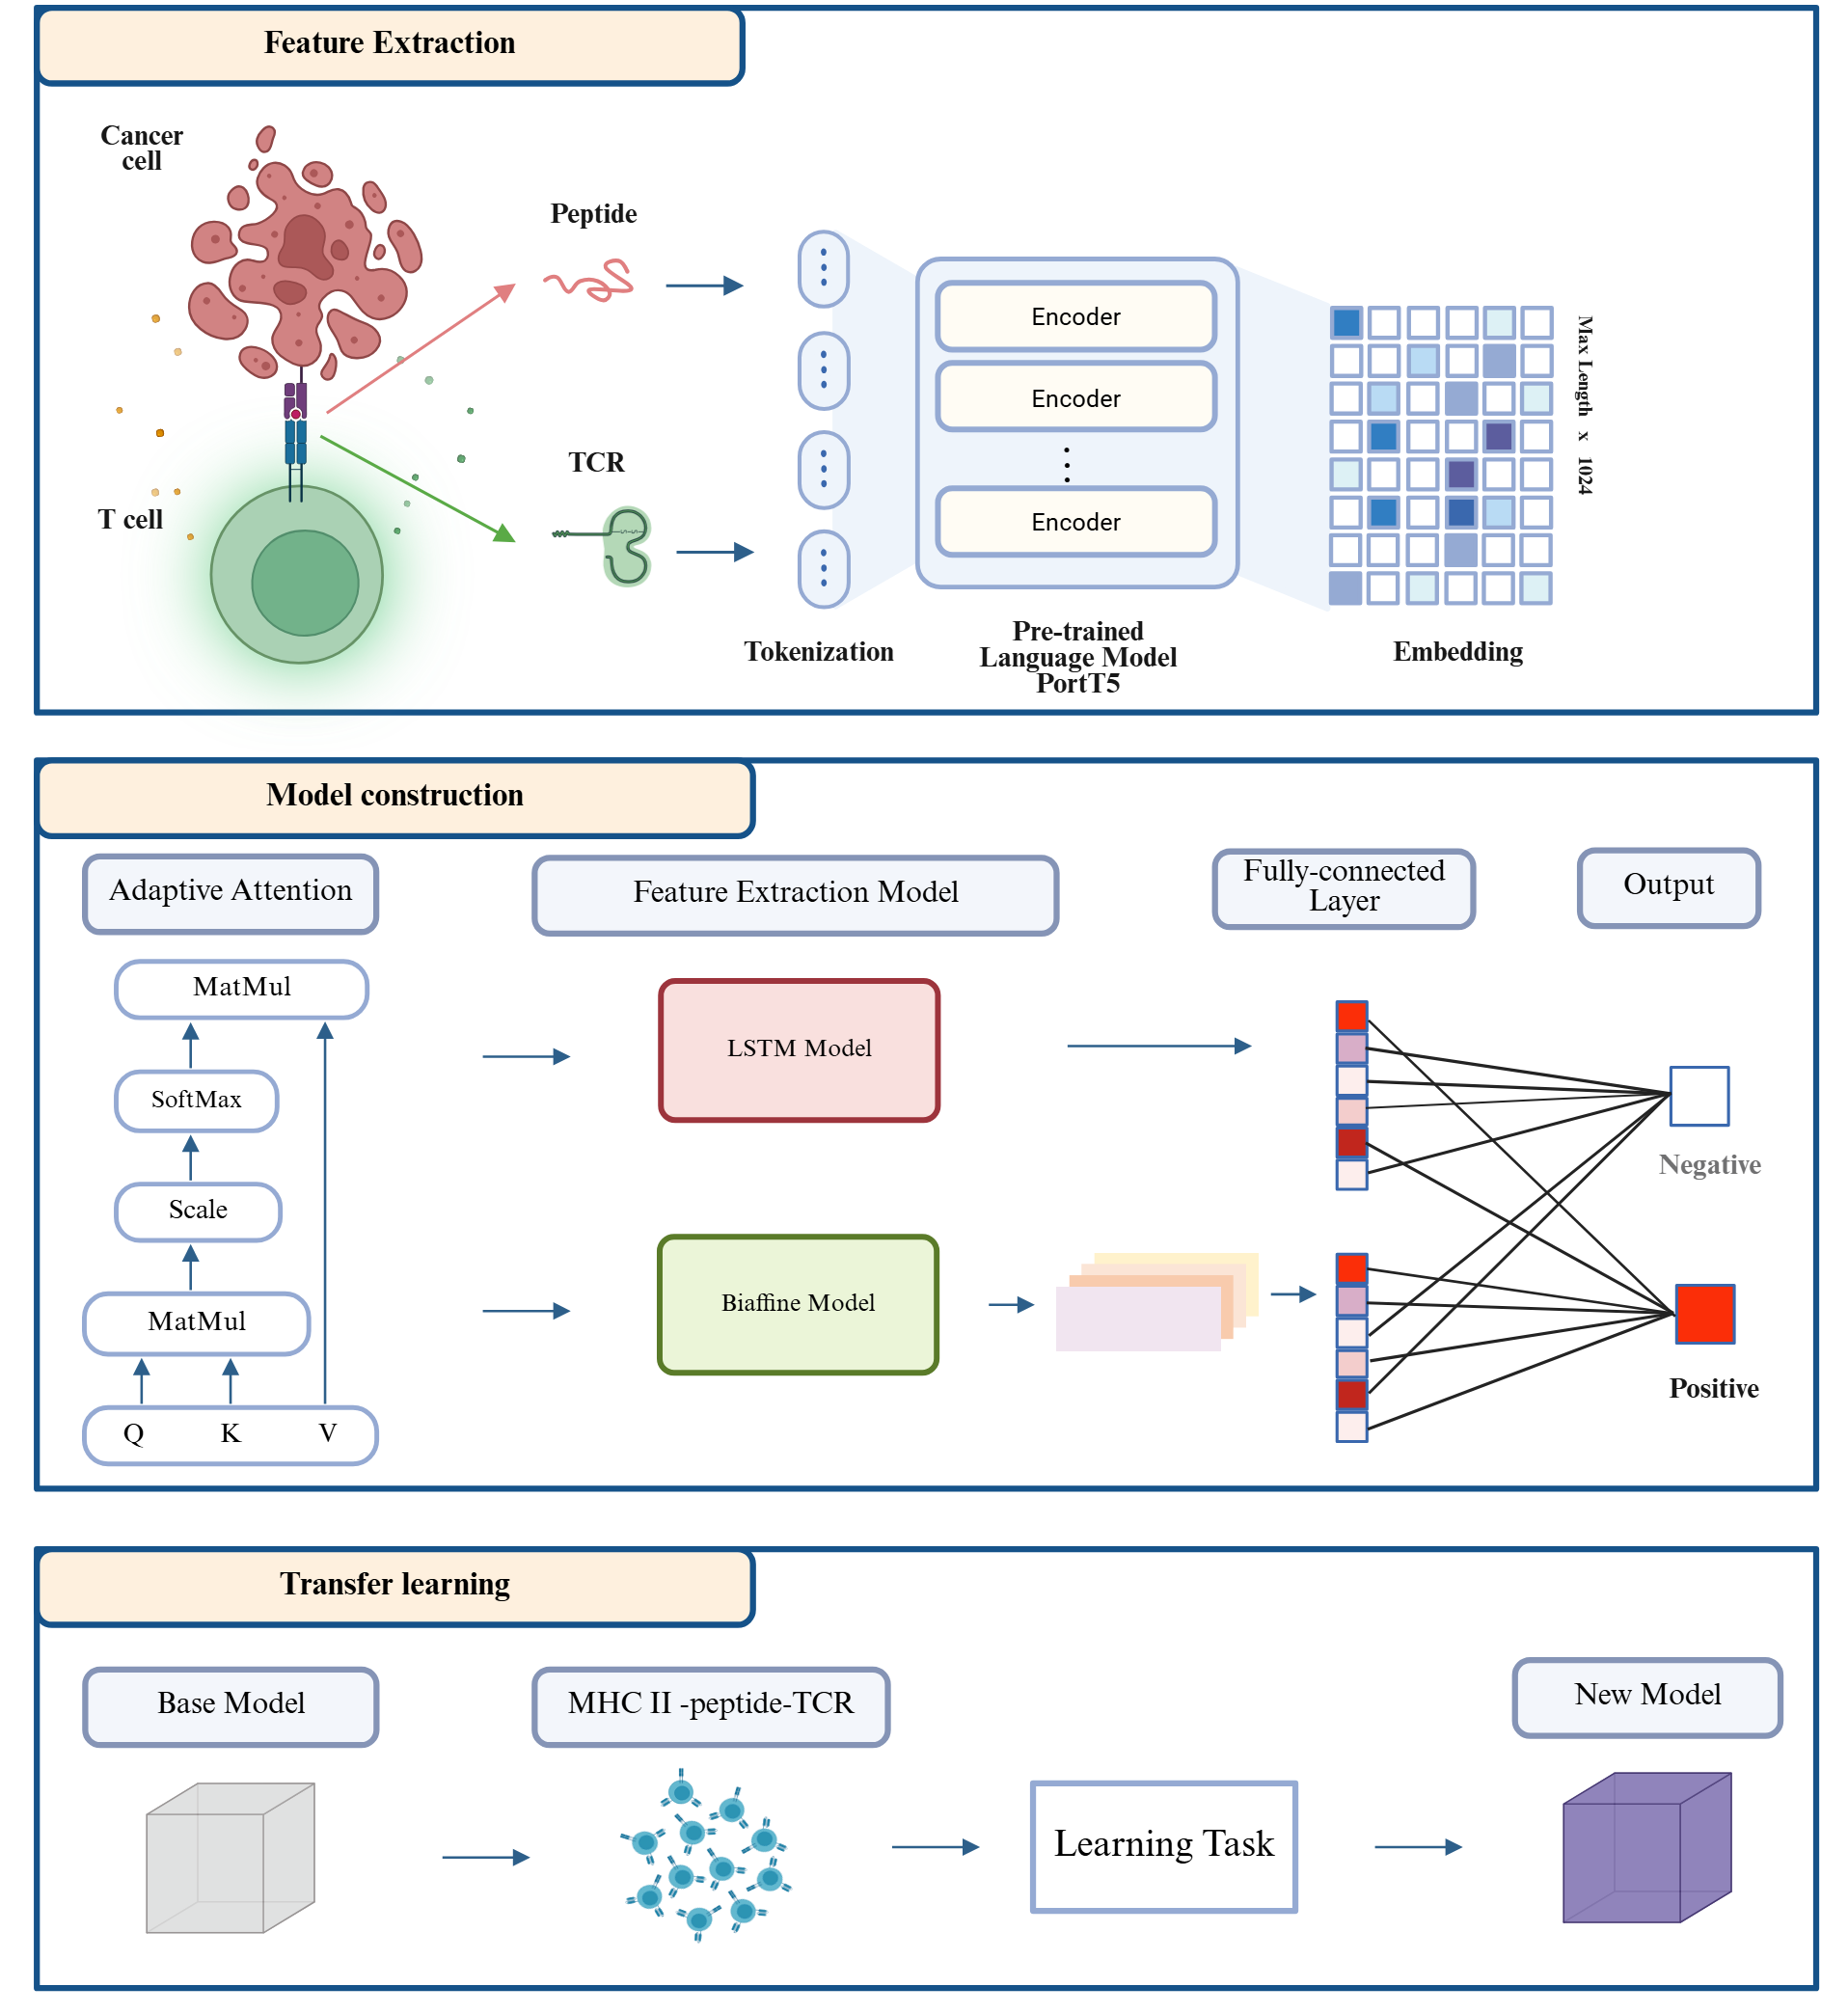
为此,我们提出了ProTCR,一个专注于解码TCR-抗原识别的人工智能框架。该框架基于蛋白质语言模型,融合深度交互建模与迁移学习策略,推动识别任务从“依赖数据记忆”向“学习可迁移规律”转变。与依赖手工特征或传统编码的方法不同,ProTCR直接借助预训练的蛋白质大模型(ProtT5)对氨基酸序列进行表示学习,将TCR和肽段映射到蕴含进化约束、结构偏好与上下文语义的连续向量空间中。这类自监督预训练模型能从海量无标签序列中学习“通用蛋白质语义”,使得ProTCR在面对有限标注数据和分布差异时,仍具备更强的泛化能力。
在追求更高预测准确性的同时,ProTCR着力提升模型的可解释性,不仅能够输出结合概率,还揭示了TCR与抗原在残基层面的相互作用,为理解识别机制提供直观线索,从而增强结果的生物可解释性与转化可信度,更好地辅助靶点筛选与实验设计。
在多项评估中,ProTCR在包括新抗原、未见肽及MHC II类表位等多种现实场景中,均表现出良好的稳健性与泛化能力。通过迁移学习策略,模型在数据更稀缺的MHC II类预测任务中也取得了良好效果,体现出稳定的跨场景适应能力。可视化分析进一步表明,模型所学表征能有效区分不同免疫识别模式,说明其掌握了深层生物学规律。
ProTCR已在多种疾病背景中完成初步验证,涵盖急性髓系白血病、实体瘤新抗原靶向以及病毒特异性T细胞识别等。结合单细胞测序数据,其预测结果与T细胞克隆扩增趋势相符,显示出在免疫治疗靶点排序及应答评估中的应用潜力。
总体而言,ProTCR通过融合蛋白质语言模型、可解释交互建模与迁移学习,显著提升了TCR-抗原识别任务在数据稀缺与复杂场景下的泛化能力,为精准免疫治疗的靶点筛选与策略优化提供了可靠的计算支持,也为后续融合多模态数据指明了方向。
该研究受到国家生物药技术创新中心项目和上海市科技创新行动计划计算生物学领域项目支持。
原文链接:https://academic.oup.com/bib/article/27/1/bbaf716/8419943